
Ai de făcut o regresie și nu știi de unde să începi?
Privat. Primul capitol gratuit. Fără avans. Plata la final sau în etape. Status constant al lucrării. Raport AI + plagiat.
Scrie-ne pe WhatsAppCum lucrăm
-
Ne scrii pe WhatsApp
Fără obligațiiTrimite ghidul, tema sau lucrarea, dacă ai început.
-
Primul capitol gratuit
GratuitPentru a vedea cum lucrăm.
-
Lucrarea finală, fără avans
Plata la final sau în etapeScriem sau modificăm lucrarea, cu status constant. Raport AI + plagiat. Primești lucrarea înainte de plată.
Cuprins · 7 secțiuni
Regresia liniară arată cât de bine prezic una sau mai multe variabile un scor și cât contribuie fiecare. Cifrele din exemple sunt calculate de noi pe datele exemplului nostru de Psihologie (148 de studenți, date simulate) și ale celui de Chimie.
R² spune ce proporție din variația variabilei dependente explică modelul, F și p dacă modelul este semnificativ, iar pentru fiecare predictor B arată cu cât se schimbă scorul la o unitate în plus și β cât contribuie, pe aceeași scală cu ceilalți. În exemplul de Psihologie: R² = .39, F(3, 144) = 30.56, p < .001, adică modelul explică 39% din variația anxietății sociale.
Regresia liniară, pas cu pas
Șapte pași, de la ecuație la fraza din capitolul de rezultate. Apasă pe unul ca să vezi ce faci, ce caută comisia și un exemplu.
1Regresia liniară simplă sau multiplă
Un predictor sau mai mulți, o variabilă dependentă numerică
Variabila dependentă este numerică (un scor, o valoare măsurată). Regresia simplă are un singur predictor: Y = a + b·X. Regresia multiplă are mai mulți: Y = a + b₁X₁ + b₂X₂ + …, iar un predictor categorial intră codat 0/1. O alegi când ipoteza spune că una sau mai multe variabile prezic un rezultat.
Comisia caută: variabila dependentă și predictorii numiți în ipoteză și în metodologie, înainte de rezultate. Ajutor: ghidul despre variabile și operaționalizare.
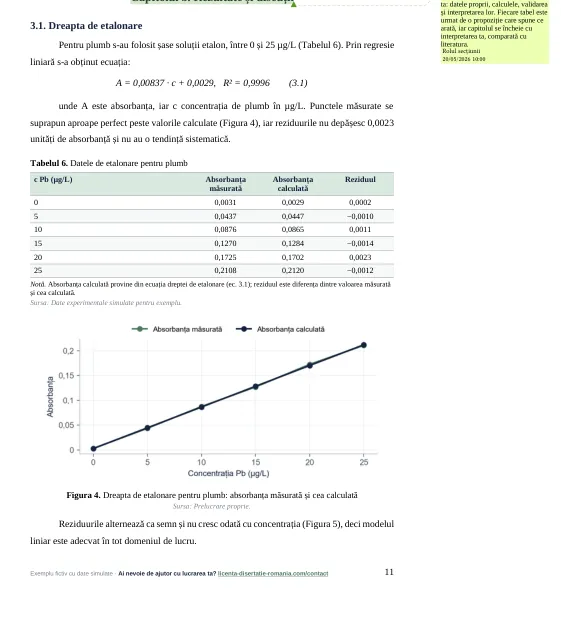
Dreapta de etalonare pentru plumb, din 6 soluții etalon: A = 0,00837 · c + 0,0029, R² = 0,9996. Am verificat-o pe datele din Tabelul 6. Ecuația servește apoi la calcul: o probă cu absorbanța 0,0198 are (0,0198 − 0,0029) / 0,00837 = 2,02 µg/L plumb.
2Presupozițiile regresiei
Reziduuri, multicoliniaritate, cazuri influente
Verifici că relațiile sunt aproximativ liniare, că reziduurile sunt independente (Durbin-Watson în jur de 2), au varianță constantă (graficul reziduuri față de valori prezise nu face o pâlnie) și o distribuție apropiată de normal, că predictorii nu sunt prea corelați între ei (VIF mic; peste 10 este o problemă clară, unii autori folosesc 5) și că niciun caz nu trage singur modelul (distanța Cook sub 1). Ca număr de participanți, o regulă orientativă des citată (Green, 1991) este cel puțin 50 + 8 × numărul de predictori.
Comisia caută: o frază cu verificările făcute, nu doar tabelul de coeficienți.
Durbin-Watson = 2.18; VIF între 1.30 și 1.63; reziduurile nu se abat semnificativ de la normal (Shapiro-Wilk, p = .427) și nu arată heteroscedasticitate (Breusch-Pagan, p = .271); distanța Cook maximă = .07. Cu 3 predictori, regula dă 74 de participanți; exemplul are 148. Câți îți trebuie ție: calculatorul de eșantion.
3Regresia liniară în SPSS
Analyze › Regression › Linear
Muți variabila dependentă la Dependent și predictorii la Independent(s), cu metoda Enter. La Statistics bifezi Estimates, Confidence intervals, Model fit, Collinearity diagnostics și Durbin-Watson; la Plots pui *ZRESID pe Y și *ZPRED pe X și bifezi histograma reziduurilor. Restul analizei în SPSS: ghidul despre analiza statistică în SPSS.
De verificat: output-ul are trei tabele de citit: Model Summary (R, R², R² ajustat, Durbin-Watson), ANOVA (F și Sig. pentru model) și Coefficients (B, Std. Error, Beta, t, Sig., VIF).
Model Summary: R Square .389, Adjusted R Square .376. ANOVA: F = 30.56, Sig. .000 (scrii p < .001). Coefficients, stima de sine: B = −0.824, Beta = −.321, Sig. .000.
4Regresia liniară în Excel
SLOPE, INTERCEPT, RSQ sau Data Analysis › Regression
Pentru regresia simplă: =SLOPE(Y; X) dă panta, =INTERCEPT(Y; X) constanta și =RSQ(Y; X) pe R²; pe un grafic de dispersie, Add Trendline › Linear cu „Display Equation” și „Display R-squared” afișează ecuația. Pentru regresia multiplă activezi Analysis ToolPak și alegi Data › Data Analysis › Regression: Input Y Range este variabila dependentă, Input X Range predictorii, în coloane alăturate, cu Labels bifat.
De verificat: Excel nu dă β, VIF sau Durbin-Watson. β îl calculezi: B × abaterea standard a predictorului / abaterea standard a variabilei dependente.
Y = coloana G (anxietatea), X = coloanele D:F (timp, comparație, stimă). Output-ul dă R Square 0,389, F 30,56, Significance F sub 0,001 și coeficienții cu P-value. β pentru stima de sine: −0,824 × 4,76 / 12,24 = −0,32. Mai multe formule: ghidul despre analiza datelor în Excel.
5Regresia în JASP sau jamovi
Gratuit, cu β, VIF și graficele reziduurilor
În JASP alegi Regression › Linear Regression: variabila dependentă la Dependent Variable, predictorii numerici la Covariates, cei categoriali la Factors; la Statistics bifezi Estimates, Model fit, Collinearity diagnostics și Durbin-Watson, iar la Plots graficul reziduurilor și Q-Q plot. În jamovi, tot Regression › Linear Regression, cu „Standardized estimate” la Model Coefficients și testele din Assumption Checks. Denumirile pot diferi puțin de la o versiune la alta.
De verificat: un predictor categorial pus la Covariates, în loc de Factors, este tratat ca număr.
Coeficienții standardizați, VIF, Durbin-Watson și graficele reziduurilor, în aceeași analiză, fără formule scrise de tine.
6Interpretarea: R², F, B și β
Cât explică modelul și ce contează în el
R² = .39 înseamnă că modelul explică 39% din variația variabilei dependente; R² ajustat corectează pentru numărul de predictori. F și p spun dacă modelul în ansamblu este semnificativ. B arată cu câte unități se schimbă, în medie, variabila dependentă la o unitate în plus a predictorului, cu ceilalți ținuți constanți; β face predictorii comparabili între ei. Un predictor cu p > .05 nu are o contribuție proprie în model.
Comisia caută: cifrele modelului, apoi fiecare predictor cu direcția lui, în limbaj de predicție („prezice”, „este asociat cu”), nu de cauză.
Anxietatea = 21.24 + 0.96 × comparația socială, R² = .31, F(1, 146) = 65.10, p < .001. Un student cu scorul 40 la comparația socială are o anxietate prezisă de 59.7, unul cu 30 de 50.1: 10 puncte la comparație înseamnă, în medie, 9.6 puncte la anxietate.
7Raportarea în stil APA
Modelul, apoi predictorii, apoi tabelul
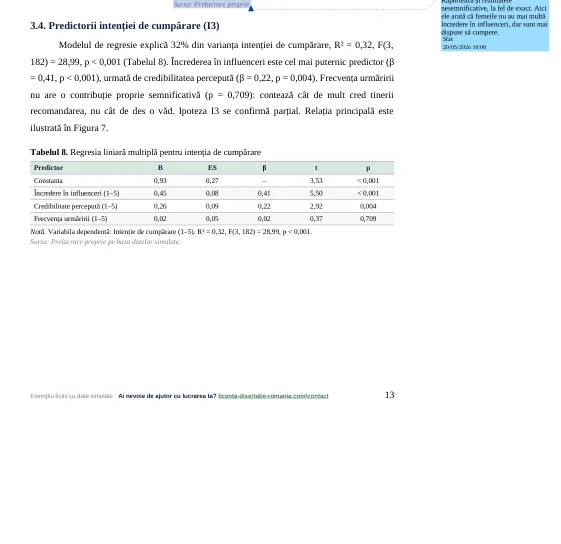
Scrii întâi modelul (R², F cu gradele de libertate, p), apoi predictorii semnificativi și pe cei nesemnificativi (β sau B, p), apoi verdictul ipotezei. În tabel pui pentru fiecare predictor B, eroarea standard, β, t și p, cu R² și F în notă. Dacă ghidul facultății cere virgula zecimală, scrii R² = 0,39, cum face exemplul nostru de Marketing (R² = 0,32).
Comisia caută: aceleași valori în text și în tabel și un verdict pentru fiecare ipoteză.
Modelul explică [x]% din varianța [variabila dependentă], R² = [valoare], F([df1], [df2]) = [valoare], p = [valoare]. [Predictorul] (β = [valoare], p = [valoare]) … Ipoteza [nr.] se confirmă / se confirmă parțial / nu se confirmă.
Cum citești celelalte teste: ghidul despre interpretarea rezultatelor statistice.
Exemplu: de la regresia simplă la cea multiplă
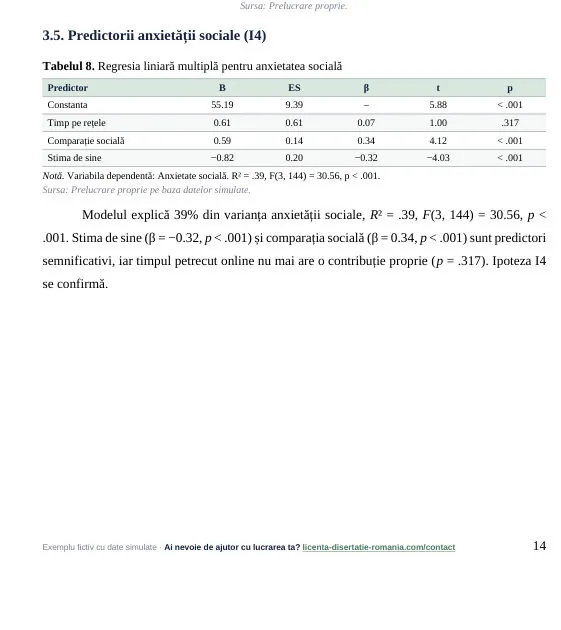
Ipoteza I4 din exemplul de Psihologie: „Comparația socială și stima de sine prezic anxietatea socială, peste efectul timpului petrecut online.” Am recalculat modelul în Python (statsmodels) din foaia „Date brute”; valorile sunt cele din Tabelul 8 al exemplului (pagina 14).
| Predictor | B | ES | β | t | p |
|---|---|---|---|---|---|
| Constanta | 55.19 | 9.39 | - | 5.88 | < .001 |
| Stima de sine | −0.82 | 0.20 | −.32 | −4.03 | < .001 |
| Comparație socială | 0.59 | 0.14 | .34 | 4.12 | < .001 |
| Timp pe rețele | 0.61 | 0.61 | .07 | 1.00 | .317 |
Variabila dependentă: anxietatea socială. R² = .39, R² ajustat = .38, F(3, 144) = 30.56, p < .001. N = 148, date simulate.
„Modelul explică 39% din varianța anxietății sociale, R² = .39, F(3, 144) = 30.56, p < .001. Stima de sine (β = −.32, p < .001) și comparația socială (β = .34, p < .001) sunt predictori semnificativi, iar timpul petrecut online nu are o contribuție proprie (β = .07, p = .317). Ipoteza I4 se confirmă.”
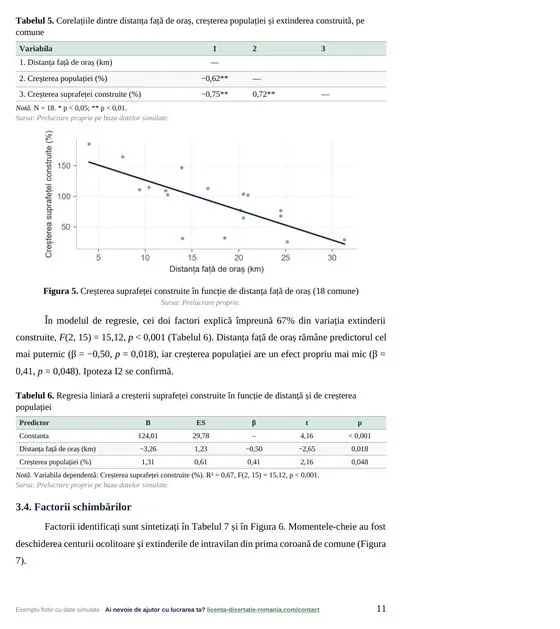
De observat: singur, timpul online corelează cu anxietatea (r = .35, vezi corelația Pearson), dar în model nu mai contează, pentru că împarte variația cu comparația socială. Iar B al comparației scade de la 0.96 în regresia simplă la 0.59 în cea multiplă, din același motiv. Pe eșantioane mici efectele trec greu pragul: în exemplul de Geografie, cu 18 comune, al doilea predictor este semnificativ la limită (β = 0,41, p = 0,048).
Mai multe despre regresia liniară
+Regresia ierarhică
Introduci predictorii în blocuri (în SPSS cu Next la Independent(s) și R squared change bifat) și vezi cât adaugă fiecare bloc peste cel dinainte. Așa testezi formulări de tipul „peste efectul lui…”.
Pasul 1, comparația socială: R² = .31. Pasul 2, plus stima de sine și timpul online: R² = .39, ΔR² = .08, F(2, 144) = 9.50, p < .001.
+Variabila dependentă da/nu
Dacă variabila dependentă are doar două valori (a cumpărat sau nu, promovat sau nu), regresia liniară nu se potrivește: folosești regresia logistică (în SPSS, Analyze › Regression › Binary Logistic). Excel nu o are. Dacă vrei doar să vezi dacă două variabile categoriale sunt asociate, ajunge testul chi pătrat.
+Greșeli frecvente
- „Comparația socială crește anxietatea cu 0.59”„un punct în plus la comparație este asociat, în medie, cu 0.59 puncte de anxietate”
- Predictorii comparați după Bcomparați după β, pe aceeași scală
- Doar R² raportatR², F, p și fiecare predictor
- Predictorul nesemnificativ scos din tabelraportat, cu p exact
- Zece predictori la 60 de participanțipuțini predictori, aleși din ipoteze
- Captură de ecran din SPSS în lucraretabel refăcut în Word, în format APA
+Regresia la licență și la disertație
La licență, un model cu câțiva predictori, tabelul și frazele pentru ipoteze sunt de obicei suficiente. La disertație merită să raportezi verificarea presupozițiilor, intervalele de încredere pentru B, un model ierarhic când ipoteza spune „peste efectul lui…” și, dacă întrebarea de cercetare o cere, moderare sau mediere. Ce cere exact programul tău scrie în ghidul facultății sau îți spune coordonatorul.
Dacă vrei ca analiza și capitolul de rezultate să fie făcute de noi, ca parte din lucrare, vezi serviciile și de ce depinde prețul.
Întrebări frecvente
Care este diferența dintre regresia liniară simplă și cea multiplă?
Regresia simplă are un singur predictor și dă ecuația unei drepte, Y = a + b·X. Regresia multiplă are doi sau mai mulți predictori și arată contribuția fiecăruia când ceilalți sunt ținuți constanți.
Ce înseamnă R² în regresie?
Proporția din variația variabilei dependente explicată de model. R² = .39 înseamnă 39%. R² ajustat corectează pentru numărul de predictori și este mai potrivit când compari modele cu număr diferit de predictori.
Care este diferența dintre B și β?
B este coeficientul nestandardizat, în unitățile variabilelor: cu cât se schimbă variabila dependentă la o unitate în plus a predictorului. β este coeficientul standardizat, pe aceeași scală pentru toți predictorii, așa că îl folosești când îi compari între ei.
Pot face regresie liniară în Excel?
Da: SLOPE, INTERCEPT și RSQ pentru regresia simplă, iar Data Analysis › Regression din Analysis ToolPak pentru cea multiplă. Excel nu dă coeficienții β, VIF sau Durbin-Watson; pentru ele folosești SPSS, JASP sau jamovi.
Ce fac dacă variabila dependentă este da/nu?
Folosești regresia logistică, nu pe cea liniară, de exemplu în SPSS prin Analyze › Regression › Binary Logistic. Pentru asocierea simplă dintre două variabile categoriale ajunge testul chi pătrat.